
 /


助力AI科研,IBM研究院打造Vela超级计算机
蓝色巨人在IBM Cloud中构建起Vela超级计算机,旨在帮助科学家创建并优化新的AI模型。
AI技术离不开强大的性能基础。IBM AI Research一直在研究新的数字与模拟处理器技术,希望借此加速AI处理速度。此次,蓝色巨人宣布在IBM Cloud中构建了一套包含60个机架的大型AI超级计算机,专门支持内部科学家和工程师。这项投资再次证实了AI技术对于研究企业的重要意义。可以想见,IBM未来可能会利用ChatGPT这类工具帮助客户群体、提升服务产品的运行效率。
最新公告
IBM研究院表示,他们已经在华盛顿特区的IBM Cloud基础设施内部署了一台包含60个机架的超级计算机,专门用于支持基础模型方面的研究。每个节点包含8个英伟达A100 GPU和80 GB HMB。IBM拒绝透露各机架安装有多少个节点,但可以肯定的是蓝色巨人这次是砸下了重金。有趣的是,IBM并没有使用HPC中常见的高成本网络互连,而是轻松通过100 Gb以太网卡承载了各节点间的通信。
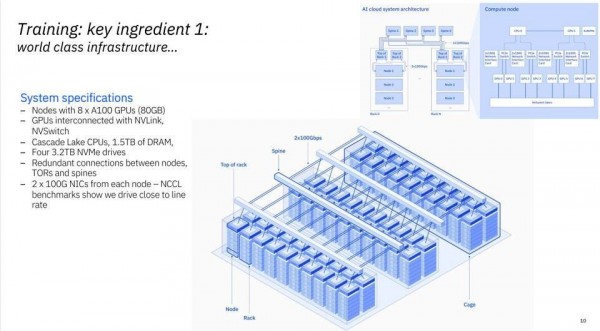
Vela超级计算机目前仅供IBM研究院的内部团队成员使用。
IBM还决定设计一个基于虚拟机的集群接口,而没有采用性能水平更高的裸机配置。IBM在博文中解释道,“我们也曾思考,到底要如何在虚拟机内部实现相当于裸机的性能?经过大量研究和发现,我们设计出一种方法,将节点上的所有功能(GPU、CPU、网络和存储)都公开到虚拟机内,这样就能让虚拟化的资源开销低于5%。根据我们无意间了解到的行业情况,这已经是最低水平了。”Vela还被原生集成至IBM Cloud的VPC环境当中,因此AI工作负载可以直接与当前200多种IBM Cloud服务随意对接。
IBM研究人员正在使用这套云端超级计算机,深入探究基础模型的执行和行为方式。最近一段时间,大语言模型已经一次又一次撼动整个行业。OpenAI打造的ChatGPT甚至在很多人眼中成为了AI版本的“iPhone时刻”。这类模型不需要监督,但却要耗费海量算力。例如,由微软Azure托管的OpenAI超级计算机就搭载10000个英伟达GPU。

IBM正使用开源“RAY”处理数据并验证基础模型。
IBM目前正倾注心力,希望帮客户建立起亲自使用这些模型的能力。除了需要占用大量资源的训练环节之外,整体流程中的数据准备、模型调整和推理处理等工作,也都拉高了客户的理解和实施门槛。
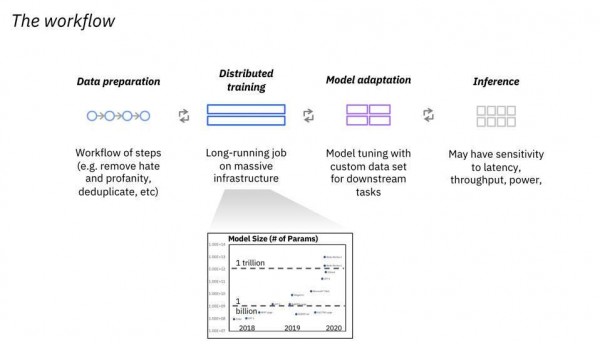
IBM关注整个工作流程,希望帮助客户为基础模型的全面普及做好准备。
从下图可以看到,IBM的目标是对特定模型版本进行定制,确保其满足特定业务需求,并将基础模型托管在云端。ChatGPT采用的是GPT3,这套模型自2021年之后就没有重新训练过了。IBM能不能找到可靠的模型更新或定制方法,又回避成本可能高达数百万美元的重新训练?看来蓝色巨人对自己很有信心。
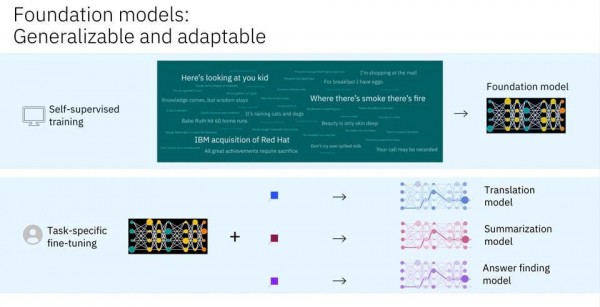
在无监督情况下训练的基础模型,可以针对特定工作负载进行微调。
总结
我们最初听说IBM AI Research时,就对他们在实验室中使用的低精度数字AI处理器,以及用于推理/训练的模拟计算基础研究印象深刻。到现在,我们才真正理解该部门关注此类技术的根本原因:基础模型就是未来,IBM希望引领自己的客户群体在充分的准备之下,大规模拥抱和部署这些模型——可能是客户的本地基础设施中,也可以在IBM Cloud或者其他公有云上。总之,在这个AI模型为王的新时代,IBM表示自己必须占据一席之地。
 0赞
好文章,需要你的鼓励

 推荐文章
英国NHS无人机快递医疗样本服务正式落地伦敦
英国国家医疗服务(NHS)正将无人机纳入常规医疗物流体系。自今年2月起,无人机每天在雷恩斯公园和圣乔治医院之间运送血液等诊断样本,飞行仅需3分钟,比公路运输快约85%,且碳排放减少高达98%。目前已有逾2000名患者受益。NHS计划将该服务扩展至圣赫利尔、克罗伊登等多家医院,最终惠及约180万名患者。该网络由英国医疗初创公司Apian与谷歌旗下Wing合作运营。
Explyt团队打造的代码智能体评测新标准:光靠“通过/失败“根本不够用
AgentLens是Explyt公司联合俄罗斯学术机构开发的AI编程助手评测基准,通过分析完整人机交互轨迹而非仅看最终结果,从五个维度评估代码智能体的真实表现。
Aetina宣布支持英伟达Jetson T3000和T2000 AI模块
边缘AI计算厂商Aetina宣布,将在其DeviceEdge AIE-KT风冷系列和新款AIE-PT无风扇平台上支持英伟达全新Jetson T3000和T2000模块。T3000基于Blackwell GPU,最高提供865 FP4 TFLOPS算力,功耗70W;T2000则提供400 FP4 TFLOPS,面向视觉AI代理和自主移动机器人等场景。两款模块预计2027年第一季度上市,支持Nemotron、Cosmos 3等英伟达AI软件生态。
机器人的“触觉觉醒“:韩国梨花女子大学如何让小型AI模型在不忘记视觉的前提下学会“感受“材质
韩国梨花女子大学提出Splash框架,通过识别AI模型中的"休眠参数"并只在其中训练触觉能力,让小型多模态AI在学会感知材质触感的同时,完整保留原有视觉语言推理能力。
2023
02/08
14:33
分享


点赞


Testin云测AI大模型测试平台:智能化测试的落地价值解析
800V直流走进数据中心,先要回答一道“安全题”
长安信托与WPS Comate共创,养出了懂业务的AI
启元机器人披露技术框架:硬件、AI、生态三道题不能有短板
UVJC 湾芯展首发 NovaJet,助力半导体产业突破传统制造规模局限
显著的性能提升进一步强化Imagination的GPU-First战略
上纬新材启元机器人新品发布会举办,全球首个个人机器人启元Q1正式开售
84年蜕变,一家日本企业在AI时代的精密执着
频繁上线机器人AI模型,靠硬件起家的宇树科技画风变了
聚力“东数西算” 打造智算枢纽 张家口飞拓低碳绿色大数据产业基地项目正式开工
柴油价格逼近每加仑10美元,加油站断供传言四起
黄仁勋称AI毁灭世界概率为零,引争议




 京公网安备 11010802021500号 京网文(2025) 0096-033号 京字第20868号