
 /


Nvidia公布首批14款AI工作负载认证服务器系统
Nvidia今天公布了第一批所谓的“ Nvidia认证系统”,主要针对那些希望大规模运行人工智能工作负载的企业组织。
Nvidia表示,已经与戴尔、HPE、技嘉、浪潮、超微等服务器制造商展开合作,为这些这些系统进行认证证明其符合最佳设计实践,并可以为最高级的机器学习和数据分析任务提供最佳性能。
这些新系统将采用Nvidia最高端的A100 GPU,并配合Mellanox高速网络适配器,为企业在企业数据中心内或者网络边缘运行AI工作负载提供更多不同选择。
Nvidia GPU云产品管理总监Adel El Hallak在新闻发布会上表示:“人工智能已经成为主流”,客户正在寻找有保障的功能、性能、可扩展性和安全性。
El Hallak说:“大规模部署AI很难,到目前为止都还是手动操作的。”他补充说,这些新认证的系统将有助于“将以前很复杂的东西变成交钥匙型方案”。
Nvidia解释说,每个经过认证的系统都已经在各种AI工作负载上进行了测试,从需要多个计算节点的工作负载,到只需要单个GPU一小部分资源的工作负载,其中每一个都经过了优化,可以运行Nvidia NGC目录中的AI应用(该目录针对GPU优化AI应用的中心)。
Nvidia解释说,这次认证涉及使用NGC目录中最受欢迎的AI框架对AI工作负载进行测试,包括深度学习训练和推理、机器学习算法、智能视频分析、网络和存储的卸载等等。
El Hallak说:“我们正在对人们实际使用的工作负载进行测试,而且测试规模是很大的。“
Constellation Research分析师Holger Mueller表示,Nvidia的软硬件都在AI方面逐步取得成功,“认证系统”正式一种典型的、行之有效的策略。
Mueller说:“企业高管喜欢得到平台认证的系统,因为这样可以确保可行性和可迁移性。更重要的是,这让企业有可能以一种面向未来的方式在本地运行AI,因为Nvidia设法在所有主流公有云中也都支持Nvidia的平台。这促使Nvidia成为一种AI的计算平台,从而为下一代应用实现了本地系统和公有云之间的工作负载可迁移性。”
Nvidia表示,截止发布时已经有14款系统通过认证可提供加速计算,包括Dell EMC PowerEdge R7525和R740机架服务器;技嘉R281-G30、R282-Z96、G242-Z11、G482-Z54、G492-Z51系统;HPE Apollo 6500 Gen10系统和HPE ProLiant DL380 Gen10服务器;浪潮NF5488A5服务器以及Supermicro A+Server AS -4124GS-TNR和AS -2124GQ-NART。
这些系统中的每一款都带有“Nvidia认证系统”的标识,证明它们是符合Nvidia最佳设计规范的,可以处理最苛刻的AI工作负载。在整个软件堆栈中都可获得企业支持,包括对开源代码的支持。
Nvidia表示,目前有来自11个系统制造商的约70个系统正在参与该计划,预计不久将宣布更多经过Nvidia认证的系统。
来源:siliconANGLE
 0赞
好文章,需要你的鼓励

 推荐文章
英国NHS无人机快递医疗样本服务正式落地伦敦
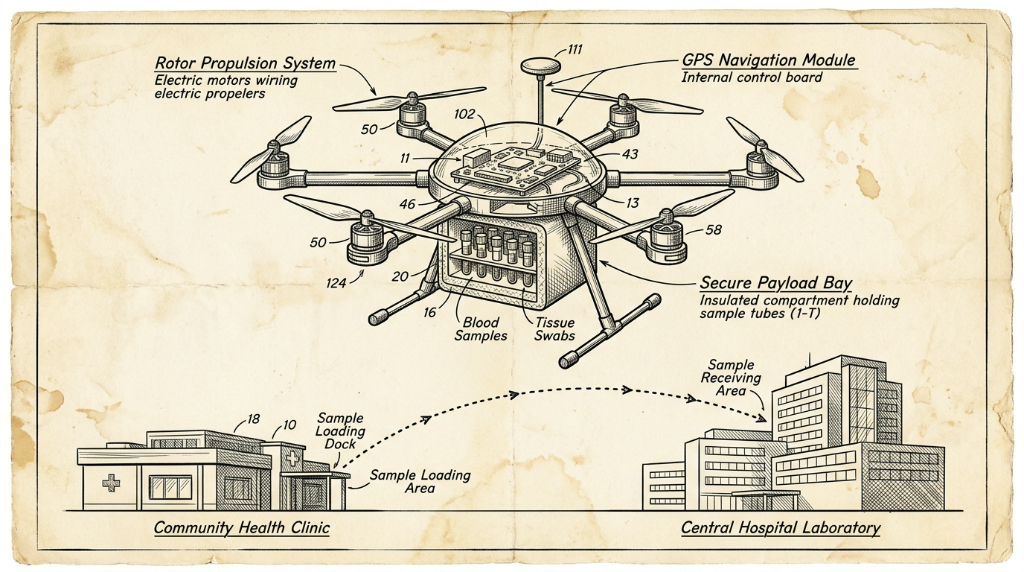
英国国家医疗服务(NHS)正将无人机纳入常规医疗物流体系。自今年2月起,无人机每天在雷恩斯公园和圣乔治医院之间运送血液等诊断样本,飞行仅需3分钟,比公路运输快约85%,且碳排放减少高达98%。目前已有逾2000名患者受益。NHS计划将该服务扩展至圣赫利尔、克罗伊登等多家医院,最终惠及约180万名患者。该网络由英国医疗初创公司Apian与谷歌旗下Wing合作运营。
Explyt团队打造的代码智能体评测新标准:光靠“通过/失败“根本不够用
AgentLens是Explyt公司联合俄罗斯学术机构开发的AI编程助手评测基准,通过分析完整人机交互轨迹而非仅看最终结果,从五个维度评估代码智能体的真实表现。
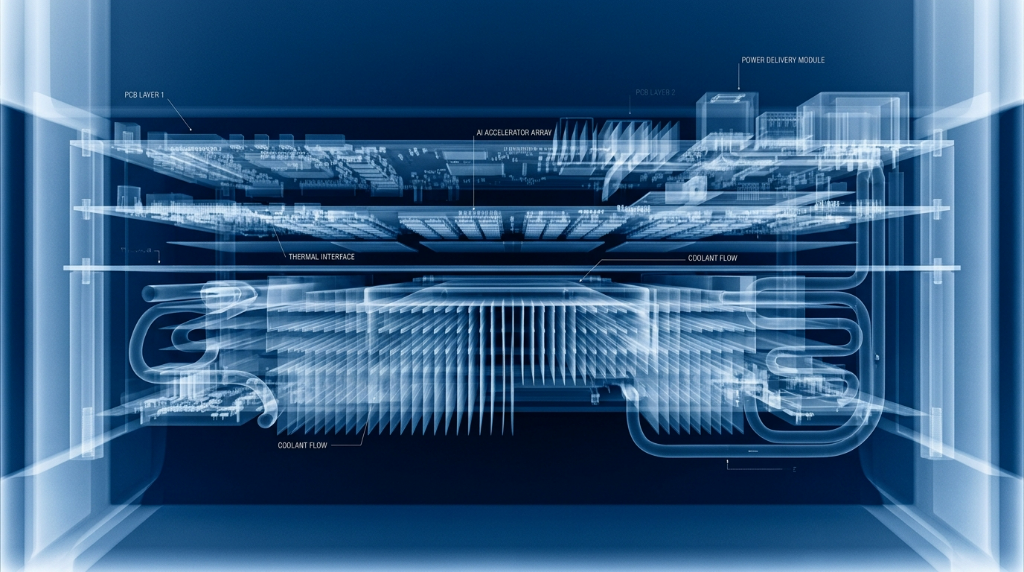
Aetina宣布支持英伟达Jetson T3000和T2000 AI模块
边缘AI计算厂商Aetina宣布,将在其DeviceEdge AIE-KT风冷系列和新款AIE-PT无风扇平台上支持英伟达全新Jetson T3000和T2000模块。T3000基于Blackwell GPU,最高提供865 FP4 TFLOPS算力,功耗70W;T2000则提供400 FP4 TFLOPS,面向视觉AI代理和自主移动机器人等场景。两款模块预计2027年第一季度上市,支持Nemotron、Cosmos 3等英伟达AI软件生态。
机器人的“触觉觉醒“:韩国梨花女子大学如何让小型AI模型在不忘记视觉的前提下学会“感受“材质
韩国梨花女子大学提出Splash框架,通过识别AI模型中的"休眠参数"并只在其中训练触觉能力,让小型多模态AI在学会感知材质触感的同时,完整保留原有视觉语言推理能力。
2021
01/28
10:44
分享


点赞


Testin云测AI大模型测试平台:智能化测试的落地价值解析
800V直流走进数据中心,先要回答一道“安全题”
长安信托与WPS Comate共创,养出了懂业务的AI
启元机器人披露技术框架:硬件、AI、生态三道题不能有短板
UVJC 湾芯展首发 NovaJet,助力半导体产业突破传统制造规模局限
显著的性能提升进一步强化Imagination的GPU-First战略
上纬新材启元机器人新品发布会举办,全球首个个人机器人启元Q1正式开售
84年蜕变,一家日本企业在AI时代的精密执着
频繁上线机器人AI模型,靠硬件起家的宇树科技画风变了
聚力“东数西算” 打造智算枢纽 张家口飞拓低碳绿色大数据产业基地项目正式开工
柴油价格逼近每加仑10美元,加油站断供传言四起
黄仁勋称AI毁灭世界概率为零,引争议
NVIDIA Blackwell 现已在云端全面可用
为“代理式AI”装上“护栏” NVIDIA打造“三重防线”
黄仁勋现身北京致辞:60年后,计算机正被重新定义
CES 2025 | NVIDIA Isaac GR00T Blueprint 让人形机器人“加速进化”
未来,就在我们手中
CES 2025 | 代理式AI崛起:NVIDIA定义下一代“代理式 AI Blueprint”
深度学习最佳 GPU,知多少?
NVIDIA推出用于多语言生成式人工智能的NeMo Retriever微服务
NVIDIA 初创加速计划 | 2024 NVIDIA 创业企业展示完美收官!
老黄掏出“迷你版AI超算”,每秒67万亿次运算,仅售2070元人民币




 京公网安备 11010802021500号 京网文(2025) 0096-033号 京字第20868号