
 /


面向数据科学 NVIDIA借助RAPIDS拓展GPU新的应用场景 原创
至顶网服务器频道 10月29日 新闻消息(文/李祥敬):毋庸置疑,我们处于一个数据大爆炸的时代,企业也在数据驱动的策略进行更多业务创新。于是,以分析、深度学习、机器学习为代表的数据科学市场迎来了快速发展发展的机遇期。为了抓住这样的商业机会,NVIDIA针对大规模数据分析和机器学习推出了RAPIDS开源GPU加速平台。
GPU瞄准新的市场
如今 ,虽然业界对于算力的需求不断加大,凭借其强大的并行计算能力,GPU在高性能计算市场表现出色。目前,包括美国Summit、Sierra;日本ABCI;欧洲的Piz Daint在内的诸多全球顶级超级计算机都采用了NVIDIA GPU作为其算力核心。而且,目前已有70%的通用HPC程序已经实现GPU加速。
同时,当前以人工智能为代表的新技术席卷各行各业,而GPU在深度学习方面具有独特的优势,NVIDIA在人工智能市场得到迅猛发展,GPU计算加速了深度学习革命。
NVIDIA亚太区解决方案架构高级总监赵立威告诉记者,整个市场还在持续快速发展,面向数据科学和机器学习的服务器市场每年价值约为200亿美元,加上科学分析和深度学习市场,高性能计算市场总价值大约为360亿美元。
除了数据科学市场,现在零售、金融、医疗等行业也在努力从数据中获得更多价值,也就是我们常说的大数据分析。“其实几乎每一家企业都在用数据驱动来增强自己的核心竞争力,而这离不开所谓的大数据决策支持系统。”赵立威说。
面对广阔的市场机会,NVIDIA GPU将目标瞄准了数据科学和机器学习市场。于是,我们看到了RAPIDS的问世。RAPIDS为GPU加速分析和机器学习提供了一整套开源库,为数据科学家提供了他们需要用来在GPU上运行整个数据科学管线的工具。
RAPIDS加速数据价值实现
赵立威表示,大数据分析一般经过三个步骤,一个是数据准备,这个过程数据特征的提取、数据合并、数据降维等等;第二步,训练。这是一个不断的循环过程,我们要不断优化,进行参数的调整,训练过程精度会更高,可预测的结果会更准确;第三步,推理,上线运营。
在这三个步骤中,业界产生了很多相应的工具,可以加速相应的过程实现。但是这些工具大多是依托处理器的计算,并没有有效利用加速器。于是,NVIDIA通过与开源社区合作,实现了GPU加速数据分析。“GPU可以给数据科学家的机器学习项目提供更多的加速支持。”赵立威说。
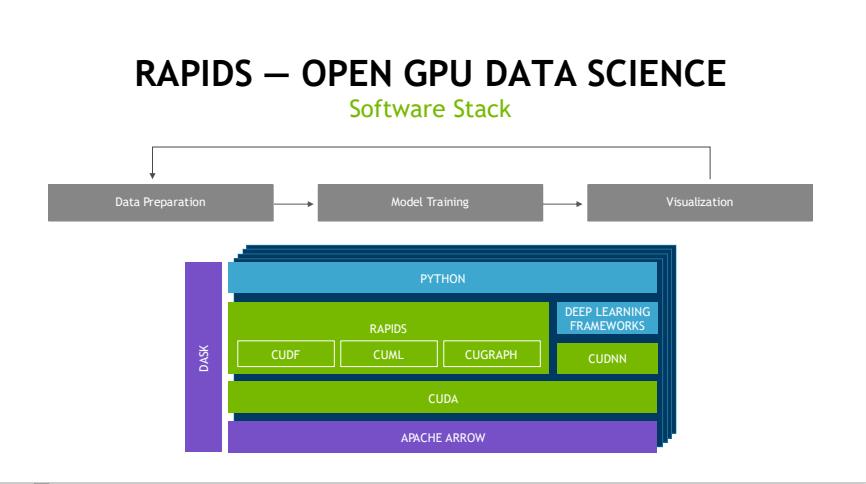
最初的RAPIDS基准分析利用了XGBoost机器学习算法在NVIDIA DGX-2系统上进行训练,结果表明,与仅有CPU的系统相比,其速度能加快50倍。这可帮助数据科学家将典型训练时间从数天减少到数小时,或者从数小时减少到数分钟,具体取决于其数据集的规模。
赵立威总结说,在方兴未艾的数据科学领域,RAPIDS具有显著的特点:无缝整合,数据科学家只需要进行非常少的代码修改就可以带来显著的性能加速;可以直接运行在NVIDIA近几年的GPU产品上面;减少数据处理等待时间,数据科学家可以将精力用在模型训练和优化;开源,更好地融入社区,获得更多人的智慧,丰富基础特性,服务更多场景。
据悉,为了推动RAPIDS的广泛应用,NVIDIA正努力将RAPIDS与Apache Spark进行整合,数据可视化将是下一个目标。
广泛的生态系统支持及应用
目前,RAPIDS已经被HPE、IBM、Oracle、Databricks等采用。在Databricks公司,开展的多个项目都在将Spark更好地与本地加速器进行整合,其中包括借助Project Hydrogen实现的Apache Arrow的支持以及GPU调度。
RAPIDS构建于Apache Arrow等流行的开源项目之上,为最流行的Python数据科学工具链带来了GPU提速。得益于CUDA及其全球生态系统以及与开源社区紧密合作,RAPIDS GPU加速平台已与全球最流行的数据科学库及工作流无缝整合,可加速机器学习。如同深度学习一样,GPU正在不断地为端到端的数据科学和机器学习流程提速。
全套RAPIDS开源库现在即可官网上获得,代码经Apache许可公布。容器化RAPIDS版本也可在NVIDIA GPU Cloud container registry上获取。
 0赞
好文章,需要你的鼓励

 推荐文章
英国NHS无人机快递医疗样本服务正式落地伦敦
英国国家医疗服务(NHS)正将无人机纳入常规医疗物流体系。自今年2月起,无人机每天在雷恩斯公园和圣乔治医院之间运送血液等诊断样本,飞行仅需3分钟,比公路运输快约85%,且碳排放减少高达98%。目前已有逾2000名患者受益。NHS计划将该服务扩展至圣赫利尔、克罗伊登等多家医院,最终惠及约180万名患者。该网络由英国医疗初创公司Apian与谷歌旗下Wing合作运营。
Explyt团队打造的代码智能体评测新标准:光靠“通过/失败“根本不够用
AgentLens是Explyt公司联合俄罗斯学术机构开发的AI编程助手评测基准,通过分析完整人机交互轨迹而非仅看最终结果,从五个维度评估代码智能体的真实表现。
Aetina宣布支持英伟达Jetson T3000和T2000 AI模块
边缘AI计算厂商Aetina宣布,将在其DeviceEdge AIE-KT风冷系列和新款AIE-PT无风扇平台上支持英伟达全新Jetson T3000和T2000模块。T3000基于Blackwell GPU,最高提供865 FP4 TFLOPS算力,功耗70W;T2000则提供400 FP4 TFLOPS,面向视觉AI代理和自主移动机器人等场景。两款模块预计2027年第一季度上市,支持Nemotron、Cosmos 3等英伟达AI软件生态。
机器人的“触觉觉醒“:韩国梨花女子大学如何让小型AI模型在不忘记视觉的前提下学会“感受“材质
韩国梨花女子大学提出Splash框架,通过识别AI模型中的"休眠参数"并只在其中训练触觉能力,让小型多模态AI在学会感知材质触感的同时,完整保留原有视觉语言推理能力。
2018
10/29
10:00
分享


点赞





 京公网安备 11010802021500号 京网文(2025) 0096-033号 京字第20868号